Что меняется
Модель и inference размещаются в инфраструктуре, которую контролирует компания, с согласованными правилами доступа и эксплуатации.
Подбираем и разворачиваем языковые модели в локальном или закрытом контуре: от выбора модели и inference-runtime до доступов, мониторинга и подключения рабочих приложений.
Состав контура определяем после разбора задач, нагрузки, требований к данным и того, где пользователи или приложения будут обращаться к модели.
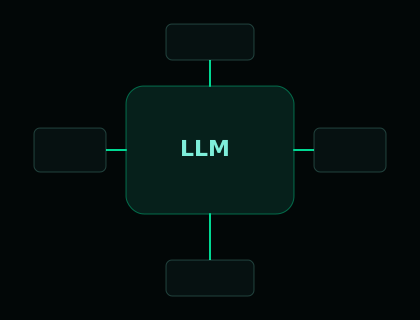
Локальная LLM — это не просто чат на сервере. Рабочий контур связывает модель, runtime, доступы, наблюдение и приложения, а конкретная архитектура зависит от сценария и нагрузки.
Модель и inference размещаются в инфраструктуре, которую контролирует компания, с согласованными правилами доступа и эксплуатации.
RAG, интеграции, пользовательский интерфейс и бизнес-логика проектируются отдельно: локальная модель становится основой, но не заменяет весь AI-сервис.
Производительность и управляемость зависят не только от выбранной модели: важны аппаратная основа, inference-стек, права доступа, приложения, наблюдение и связи с другими системами.
Сервер или AI-станция подбираются под память, нагрузку и план роста.
Inference-слой отвечает за запуск модели, API и обработку запросов.
Роли, ограничения и журналирование определяют, кто и как использует модель.
 ЛОКАЛЬНАЯ LLM / ИСПОЛНЕНИЕ
Чат, внутренние инструменты и сервисы подключаются через согласованные интерфейсы.
Метрики и логи нужны для контроля нагрузки, ошибок и эксплуатации.
RAG, CRM/ERP и другие системы подключаются отдельными управляемыми контурами.
Последовательность помогает не выбирать модель в отрыве от реальной эксплуатации: сначала определяется рабочий профиль, затем runtime, доступы и приложения.
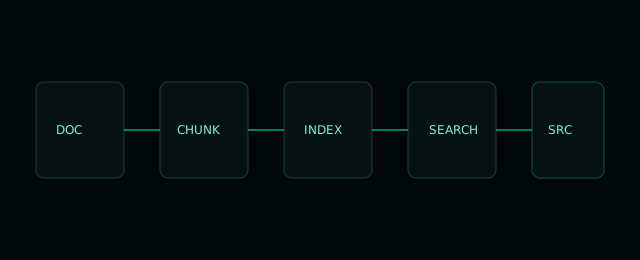
Выбираем класс модели под язык, качество ответа, контекст и доступные ресурсы.
Разворачиваем inference и API в согласованной инфраструктуре.
Настраиваем роли, ограничения, журналы и правила использования.
Подключаем внутренний чат, RAG, AI-функции или другие рабочие сервисы.
Ценность появляется не от самого факта локального запуска, а когда модель встроена в понятный сценарий и сотрудники получают контролируемую точку доступа.
Порядок не начинается с названия модели. Сначала фиксируем сценарий и нагрузку, затем выбираем модель и инфраструктуру, после чего проверяем работу на реальных запросах.
Фиксируем задачи, пользователей, формат ответа, ограничения по данным и интеграции.
Сопоставляем качество, язык, контекст и требования к памяти и вычислительным ресурсам.
Настраиваем inference-сервис, API, доступы и базовую телеметрию.
Проверяем типовые запросы, параллельность, ограничения и поведение под рабочей нагрузкой.
Документируем запуск, обновление модели, мониторинг и точки ответственности.
Для первичной оценки не нужен готовый технический проект. Достаточно описать рабочие задачи, ожидаемую нагрузку, ограничения по данным и существующую инфраструктуру.
Какие операции должна выполнять модель: чат, анализ, генерация, RAG или функции внутри приложений.
Число пользователей, параллельные запросы, длина контекста и ожидания по отклику.
Требования к локальному размещению, внешним API, сетевому доступу и журналированию.
Какие приложения, базы знаний, CRM/ERP или внутренние сервисы должны использовать модель.
Короткие ответы для первичной оценки. Точная модель и конфигурация определяются после проверки сценария, нагрузки и ограничений.
Нет. Локальный вариант нужен не всем. Он оправдан, когда контроль данных, интеграции и политика безопасности важнее удобства публичного API.
Да. Частый сценарий: документы индексируются локально, а модель формирует ответы по найденным фрагментам. RAG и модельный runtime при этом остаются отдельными слоями системы.
Не обязательно. Сначала можно оценить задачи, нагрузку, требования к модели и ограничения по данным, а затем подобрать конфигурацию оборудования.
На скорость влияют модель, формат и квантование, длина контекста, доступная память и вычислительные ресурсы, а также число одновременных запросов. Поэтому производительность оценивается на конкретном рабочем профиле.
Опишите задачи, предполагаемую нагрузку, ограничения по данным и доступную инфраструктуру. Сначала определим рабочий профиль, затем модель, runtime и требования к оборудованию.


