01 / ОБОРУДОВАНИЕ ДЛЯ ИИ

AI-станции и GPU-серверы для локального искусственного интеллекта

Подбираем вычислительную инфраструктуру под модели, корпоративные данные, число пользователей и режим эксплуатации — от компактной AI-станции для пилота до серверного контура под несколько команд и сервисов.

Модели и контекст Данные и RAG Пользователи и нагрузка Интеграции и доступы
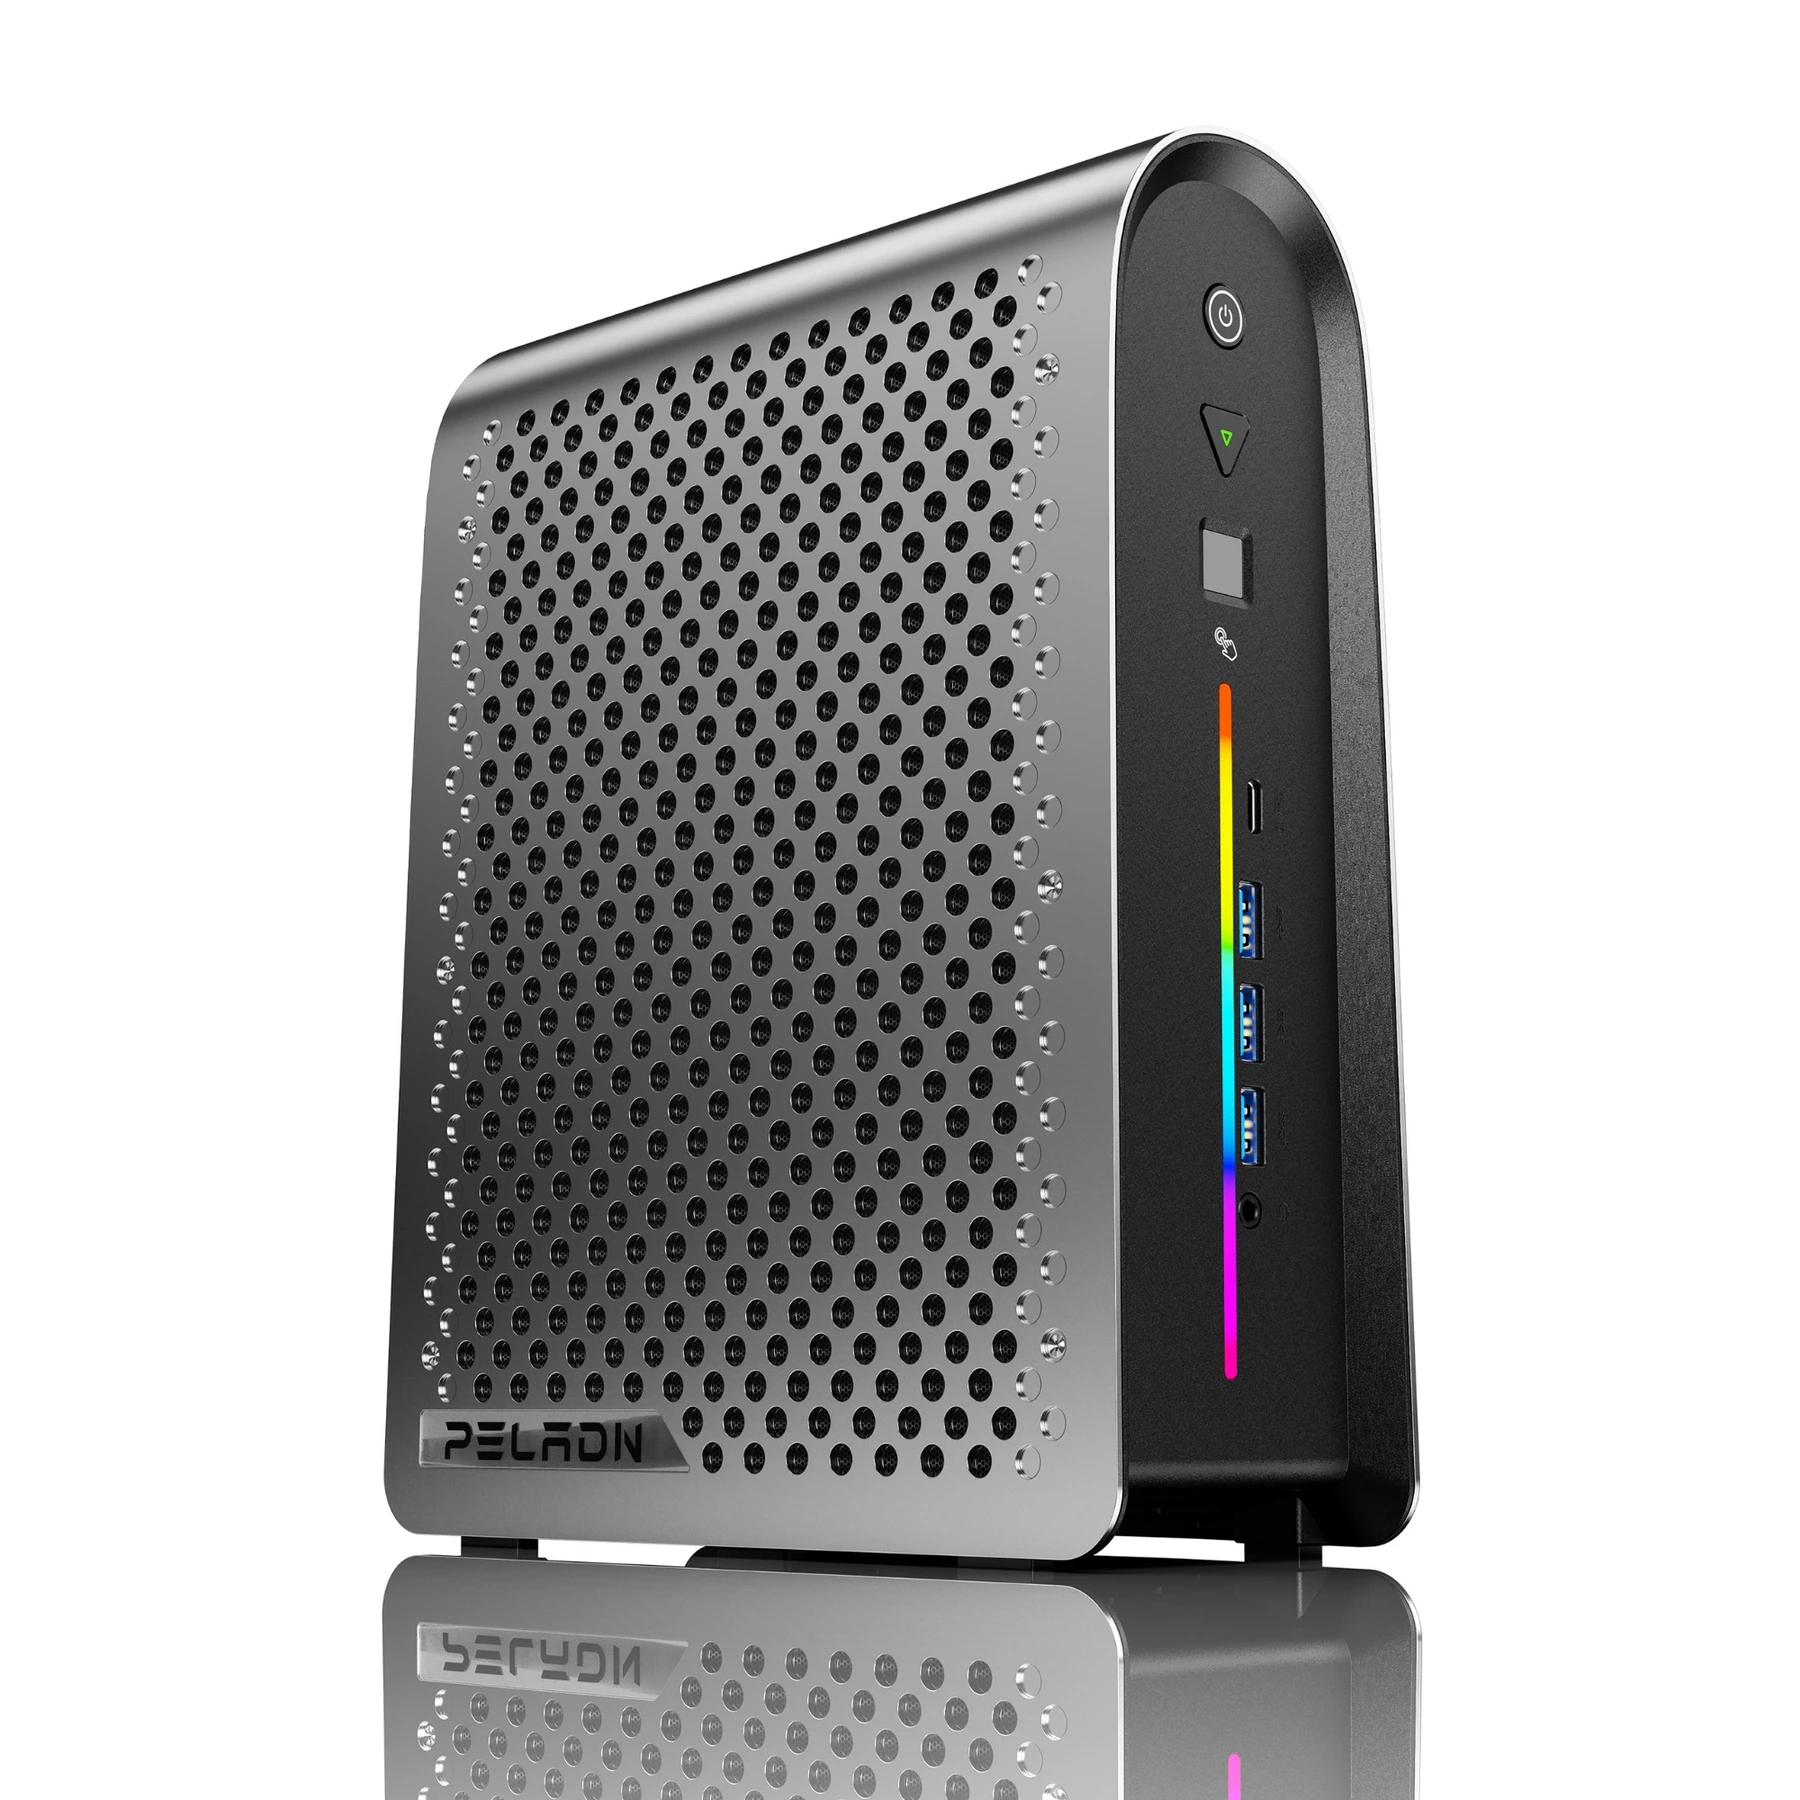
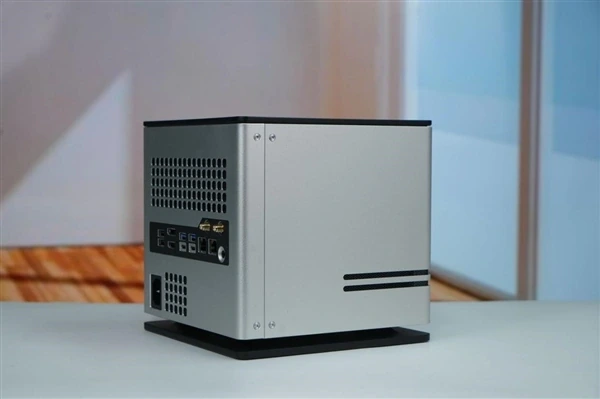
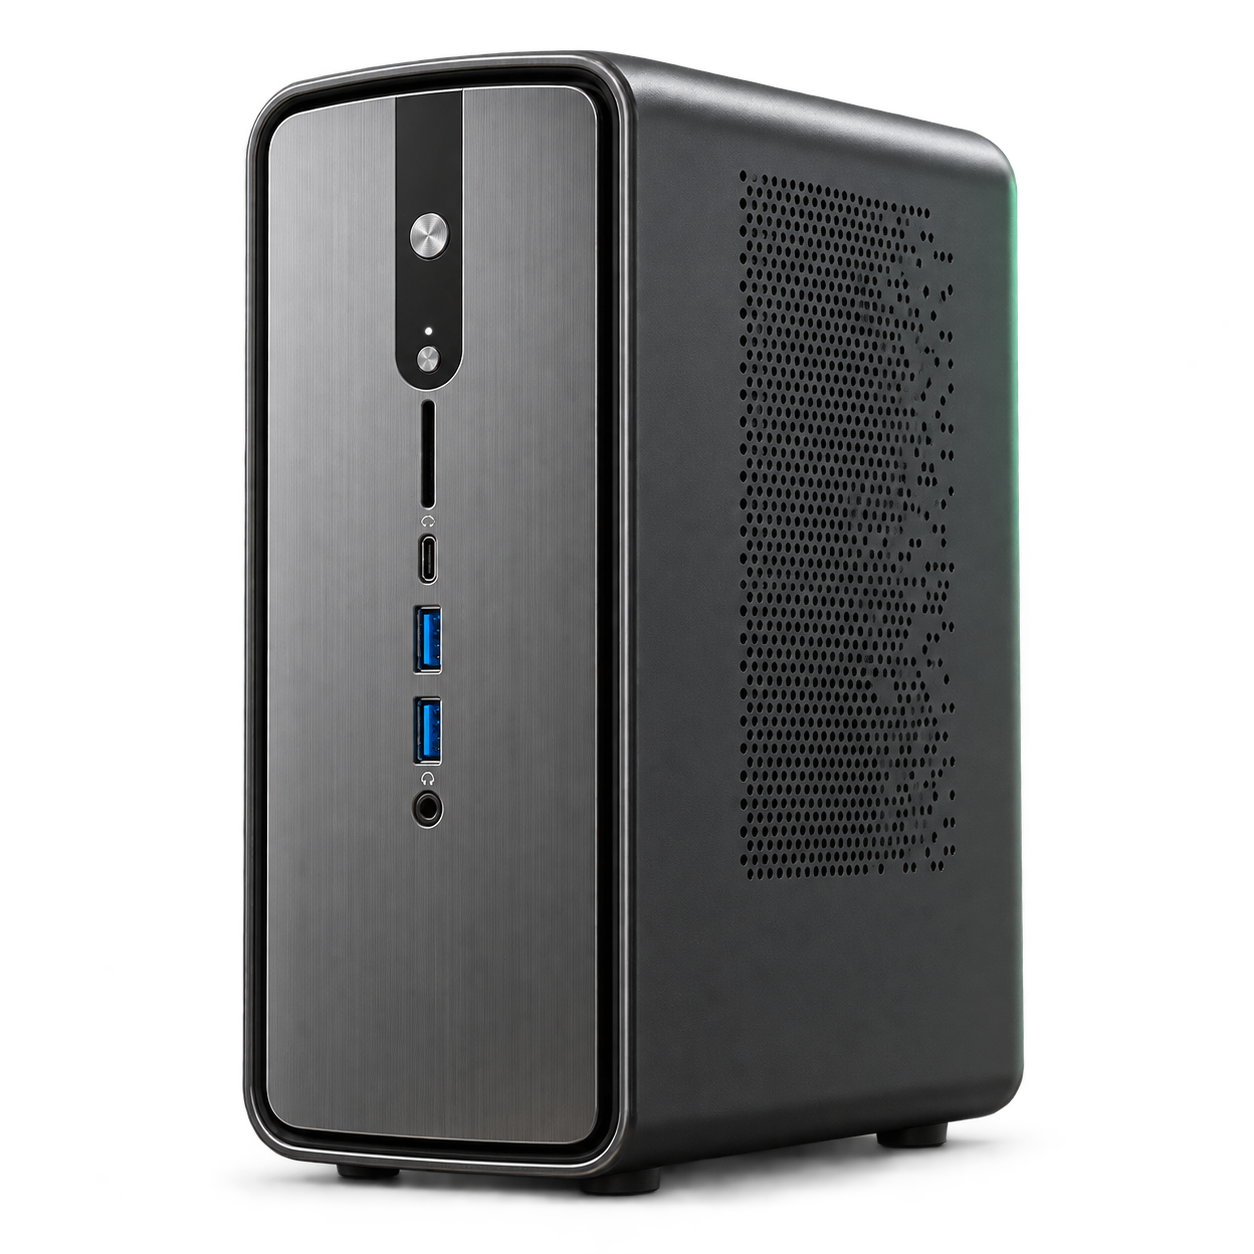
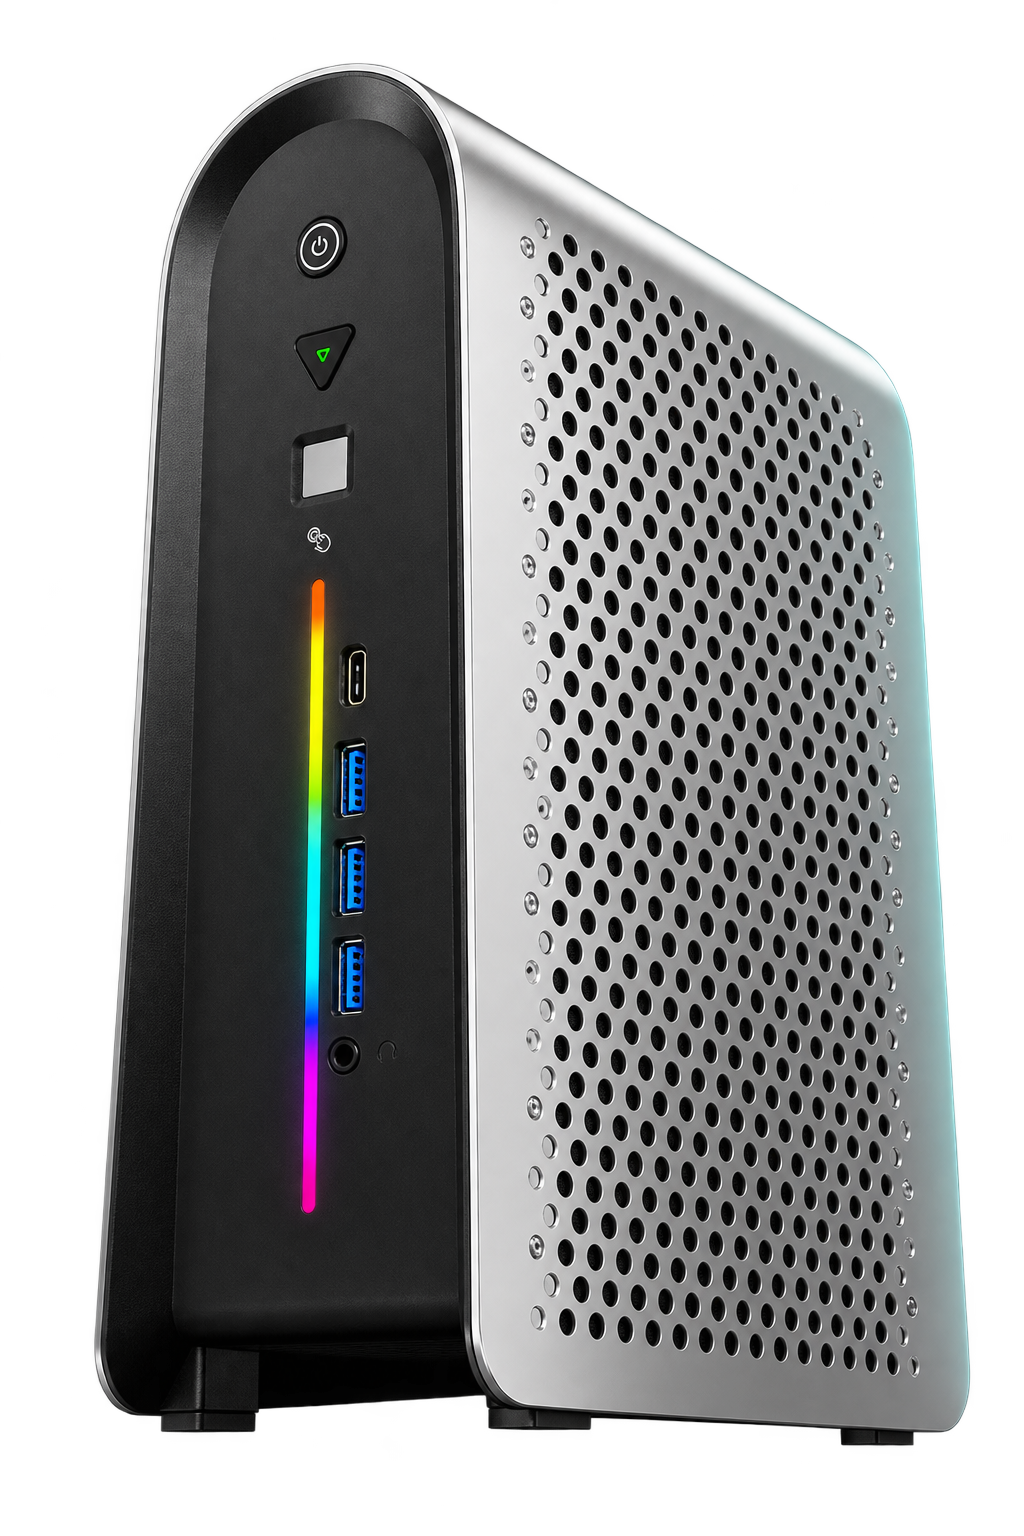
AI-станция в тёмном вертикальном корпусе AI-станция в светлом корпусе AI-СТАНЦИИ / ЛОКАЛЬНЫЙ КОНТУР
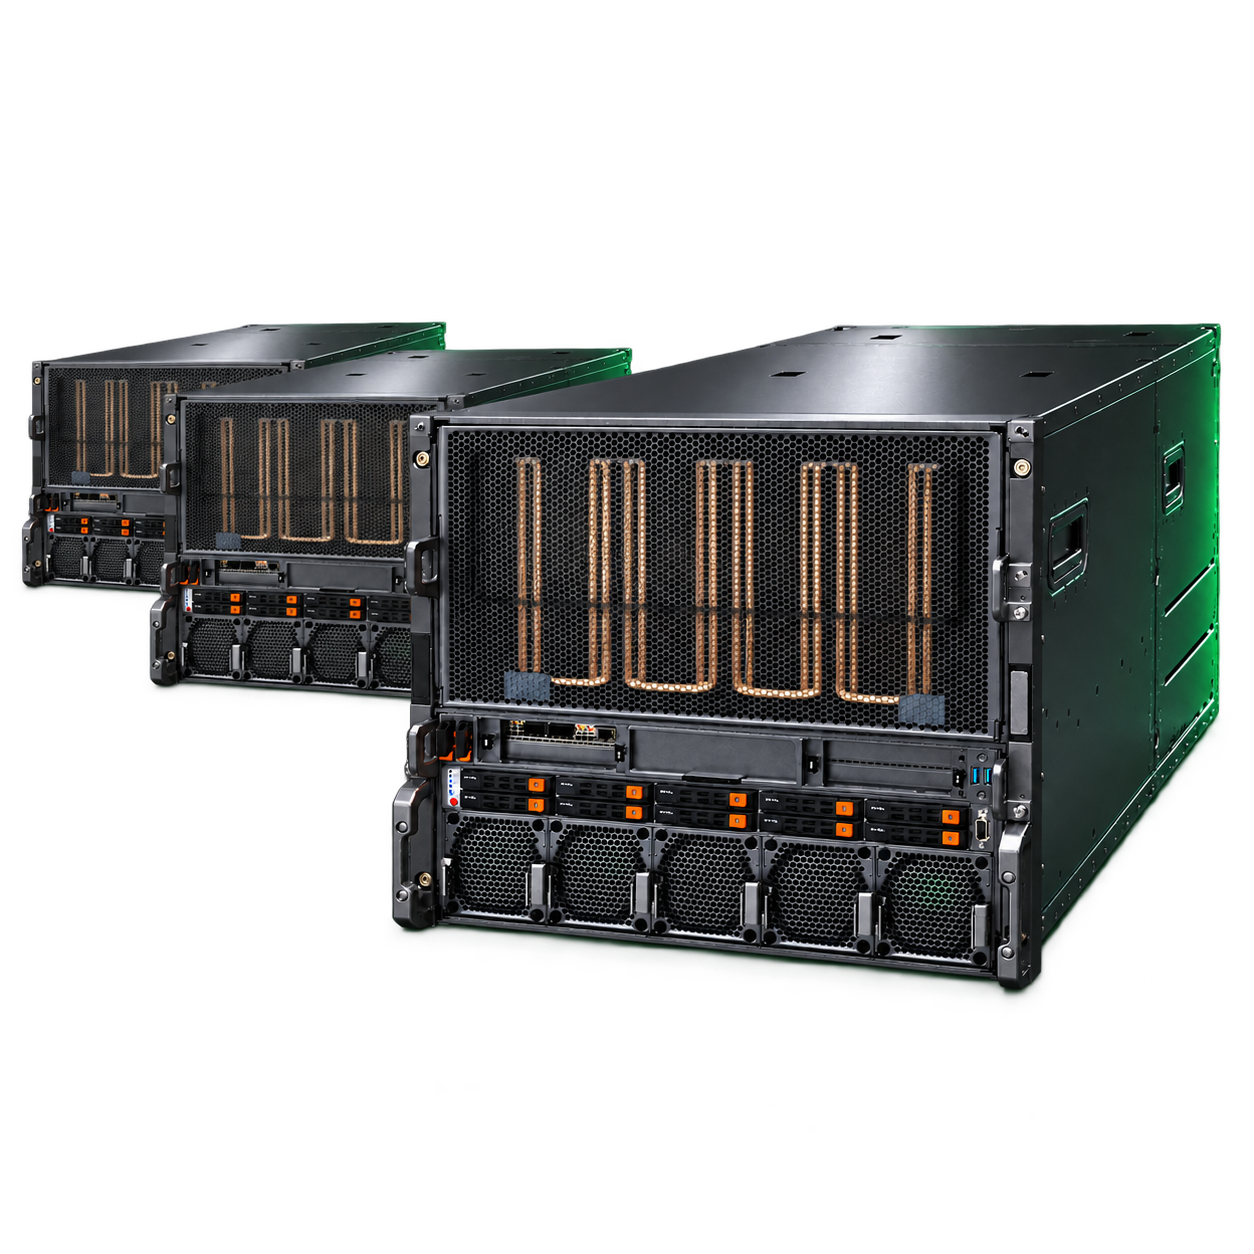
Группа GPU-серверов для корпоративной ИИ-инфраструктуры GPU-СЕРВЕРЫ / МАСШТАБ
ДВА КЛАССА От рабочей станции до серверной инфраструктуры

Подбираем класс оборудования после оценки моделей, данных и нагрузки.

Сравнить подходы ↗
02 / ДВА КЛАССА ОБОРУДОВАНИЯ

От компактной AI-станции до серверного контура

Оба варианта работают внутри общей архитектуры: модели, документы, приложения, роли и интеграции. Различается вычислительный масштаб и режим эксплуатации.

Тёмная AI-станция для локальных моделей Светлая AI-станция для локального искусственного интеллекта
01
КОМПАКТНЫЙ ЛОКАЛЬНЫЙ КОНТУР

AI-станции

Для пилотов, рабочих групп, локального RAG, внутренних помощников и сценариев, где вычисления нужно разместить рядом с корпоративными данными.

ПодходитПилотам и командам

Когда нужен контролируемый старт без отдельной серверной платформы.

СценарииRAG, LLM, помощники

Поиск по документам, чат, локальные прикладные сервисы.

Следующий шагКаталог станций

В каталоге собраны AI-станции для локальных моделей, RAG, разработки и пилотных контуров. Актуальную ревизию и комплектацию подтверждаем перед заказом.

Открыть каталог AI-станций ↓
GPU-сервер для локальных LLM и корпоративной ИИ-инфраструктуры
02
СЕРВЕРНАЯ ИНФРАСТРУКТУРА

GPU-серверы и стойки

Для высокой нагрузки, нескольких команд и нескольких ИИ-сервисов: локального инференса, RAG-платформы, обработки документов и корпоративных приложений.

ПодходитНескольким командам

Когда нужен общий серверный ресурс и предсказуемый режим эксплуатации.

СценарииLLM, RAG, пакетная обработка, агенты

Несколько сервисов, очереди, интеграции и централизованный доступ.

Следующий шагПроектная спецификация

GPU, память, сеть, хранение и резерв определяются после оценки нагрузки.

Открыть каталог GPU-серверов ↗
03 / ЛОГИКА ВЫБОРА

Конфигурация начинается с нагрузки, а не с названия GPU

Чтобы не покупать лишнее железо и не упереться в ограничения после запуска, сначала определяем рабочий сценарий, данные, модельный слой и требования к эксплуатации.

01

Какие модели будут работать

Размер модели, контекст, режим инференса и число параллельных задач влияют на вычислительный профиль.

02

Сколько пользователей и сервисов

Пилот одной команды и корпоративный контур с несколькими приложениями требуют разного запаса ресурсов.

03

Где находятся данные

Документы, базы знаний, CRM и ERP определяют требования к хранению, сети, RAG и правилам доступа.

04

Как система будет эксплуатироваться

Учитываем мониторинг, обновления, резерв, роли сотрудников и ответственность за рабочий ИИ-контур.

Нужен быстрый локальный пилот Начинаем с AI-станции
Нужна высокая или общая нагрузка Проектируем GPU-сервер
Требования ещё не определены Сначала проводим подбор
Открыть сравнение ↗
04 / ОБОРУДОВАНИЕ В СИСТЕМЕ

Железо становится полезным после подключения данных и сервисов

Neuroserver связывает оборудование с локальными моделями, RAG, корпоративными приложениями и эксплуатацией — чтобы сервер не оставался отдельной коробкой.

01

Оборудование

AI-станция или GPU-сервер под вычислительный профиль.

02

Данные и RAG

Документы, базы знаний, индексы и видимые источники.

03

Модельный слой

Локальная LLM и правила работы под конкретные задачи.

04

Интеграции

CRM, ERP, портал, API и внутренние приложения.

05

Эксплуатация

Доступы, мониторинг, обновления, обучение и сопровождение.

05 / ВОПРОСЫ ПЕРЕД ПОКУПКОЙ

Что важно понять до выбора AI-станции или GPU-сервера

Короткие ответы о масштабе, конфигурации и связи оборудования с рабочим ИИ-контуром.

Главное различие — масштаб и режим эксплуатации.

AI-станция удобна для пилота, рабочей группы и локальных сценариев. GPU-сервер выбирают, когда нужны более высокая нагрузка, несколько сервисов или общий вычислительный ресурс для команд.

Можно определить класс решения, но не финальную спецификацию.

Для точного подбора желательно понимать модельный слой, контекст, число пользователей, режим нагрузки и запас на развитие.

Не всегда.

Если задача ещё проверяется, компактная AI-станция может быть рациональнее: на пилоте можно уточнить качество, нагрузку и требования до масштабирования.

Возможен как подбор оборудования, так и проект под ключ.

В полном контуре к вычислительной части добавляются RAG, локальные модели, интеграции, доступы, обучение и правила эксплуатации.

Достаточно описать сценарий и ожидаемую нагрузку.

Полезны типы данных, число пользователей, используемые модели или задачи, существующие системы и ограничения по размещению.

Да, если конфигурация соответствует объёму данных и нагрузке.

RAG включает не только запуск модели, но и индекс, обновление документов, права доступа, поиск по источникам и прикладной интерфейс.

Запас и путь развития закладываются при проектировании.

Мы разделяем то, что нужно пилоту сейчас, и то, что потребуется при росте пользователей, сервисов, моделей и объёма корпоративных данных.

Не начинать с покупки максимальной конфигурации.

Сначала стоит описать процессы, данные и ограничения, после чего сравнить AI-станцию, GPU-сервер и вариант поэтапного запуска.

06 / СЛЕДУЮЩИЙ ШАГ

Подберём оборудование под ваш AI-проект

Расскажите, какие модели и данные должны работать локально, сколько будет пользователей и какие системы нужно подключить. Предложим класс оборудования и следующий технический шаг.